SuperCLUE 幻觉控制评测
测模型做中文生成任务时应对忠实性幻觉的能力。
「忠实性幻觉」指的是:输出读起来通顺、结构完整,但内容和给定原文对不上——凭空添加、张冠李戴、无中生有。任务类型包括文本摘要、阅读理解、多文本问答、对话补全等。
- 准备一批中文任务数据集,每题都有人工校验过的参考答案;
- 把模型输出按句拆分,逐句与参考答案做二元判定(对 / 错);
- 汇总成满分 100 的得分。
因为是逐句判定而不是整体打分,所以对「通篇流畅但夹带私货」这种最典型的幻觉更敏感——整体打分很容易被流畅的文笔带过去。
只看一件事:模型说的每句话,能不能在参考答案里站住。
不评文笔,不评创意,也不评推理。这也是它和大多数榜单不重叠的地方。
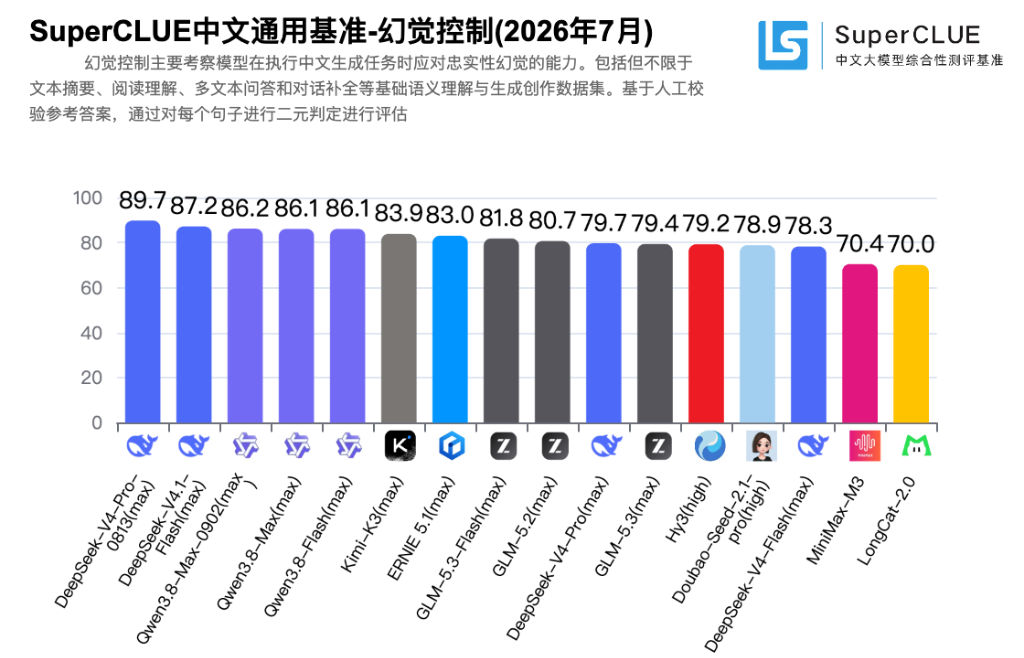
2026 年 7 月榜,共 16 个模型配置:
| 排名 | 模型 | 得分(满分 100) |
|---|---|---|
| 1 | DeepSeek-V4-Pro-0813(max) | 89.70 |
| 2 | DeepSeek-V4.1-Flash(max) | 87.20 |
| 3 | Qwen3.8-Max-0902(max) | 86.20 |
| 4 | Qwen3.8-Max(max) | 86.10 |
| 5 | Qwen3.8-Flash(max) | 86.10 |
| 6 | Kimi-K3(max) | 83.90 |
| 7 | ERNIE 5.1(max) | 83.00 |
| 8 | GLM-5.3-Flash(max) | 81.80 |
| 9 | GLM-5.2(max) | 80.70 |
| 10 | DeepSeek-V4-Pro(max) | 79.70 |
| 11 | GLM-5.3(max) | 79.40 |
| 12 | Hy3(high) | 79.20 |
| 13 | Doubao-Seed-2.1-Pro(high) | 78.90 |
| 14 | DeepSeek-V4-Flash(max) | 78.30 |
| 15 | MiniMax-M3 | 70.40 |
| 16 | LongCat-2.0 | 70.00 |
三点值得注意:
- 首尾差了近 20 分:第一名 89.7,最后一名 70.0。防幻觉这件事上,模型之间的差距是实打实的;
- 前 7 名都在 83 分以上,之后逐级下滑,70 分档的两个模型明显掉队;
- 同名模型的不同版本差距不小:DeepSeek-V4-Pro-0813 得 89.7,DeepSeek-V4-Pro 只有 79.7,差 10 分。看榜要认准版本号,别只看名字。